meshlet
Meshlet 是什么?为什么 GPU 渲染需要把三角形”切块”?
从一个真实场景讲起:假设你要渲染一片 78 万个三角形的地面,相机只看得到其中一小块。你当然希望”看不到的三角形就别画了”。但问题是——你以多大的颗粒度去判断”看得到还是看不到”? 这个问题的答案,就是 meshlet 存在的原因。
这个场景我放到自制微引擎case5,可以直接clone下来运行:
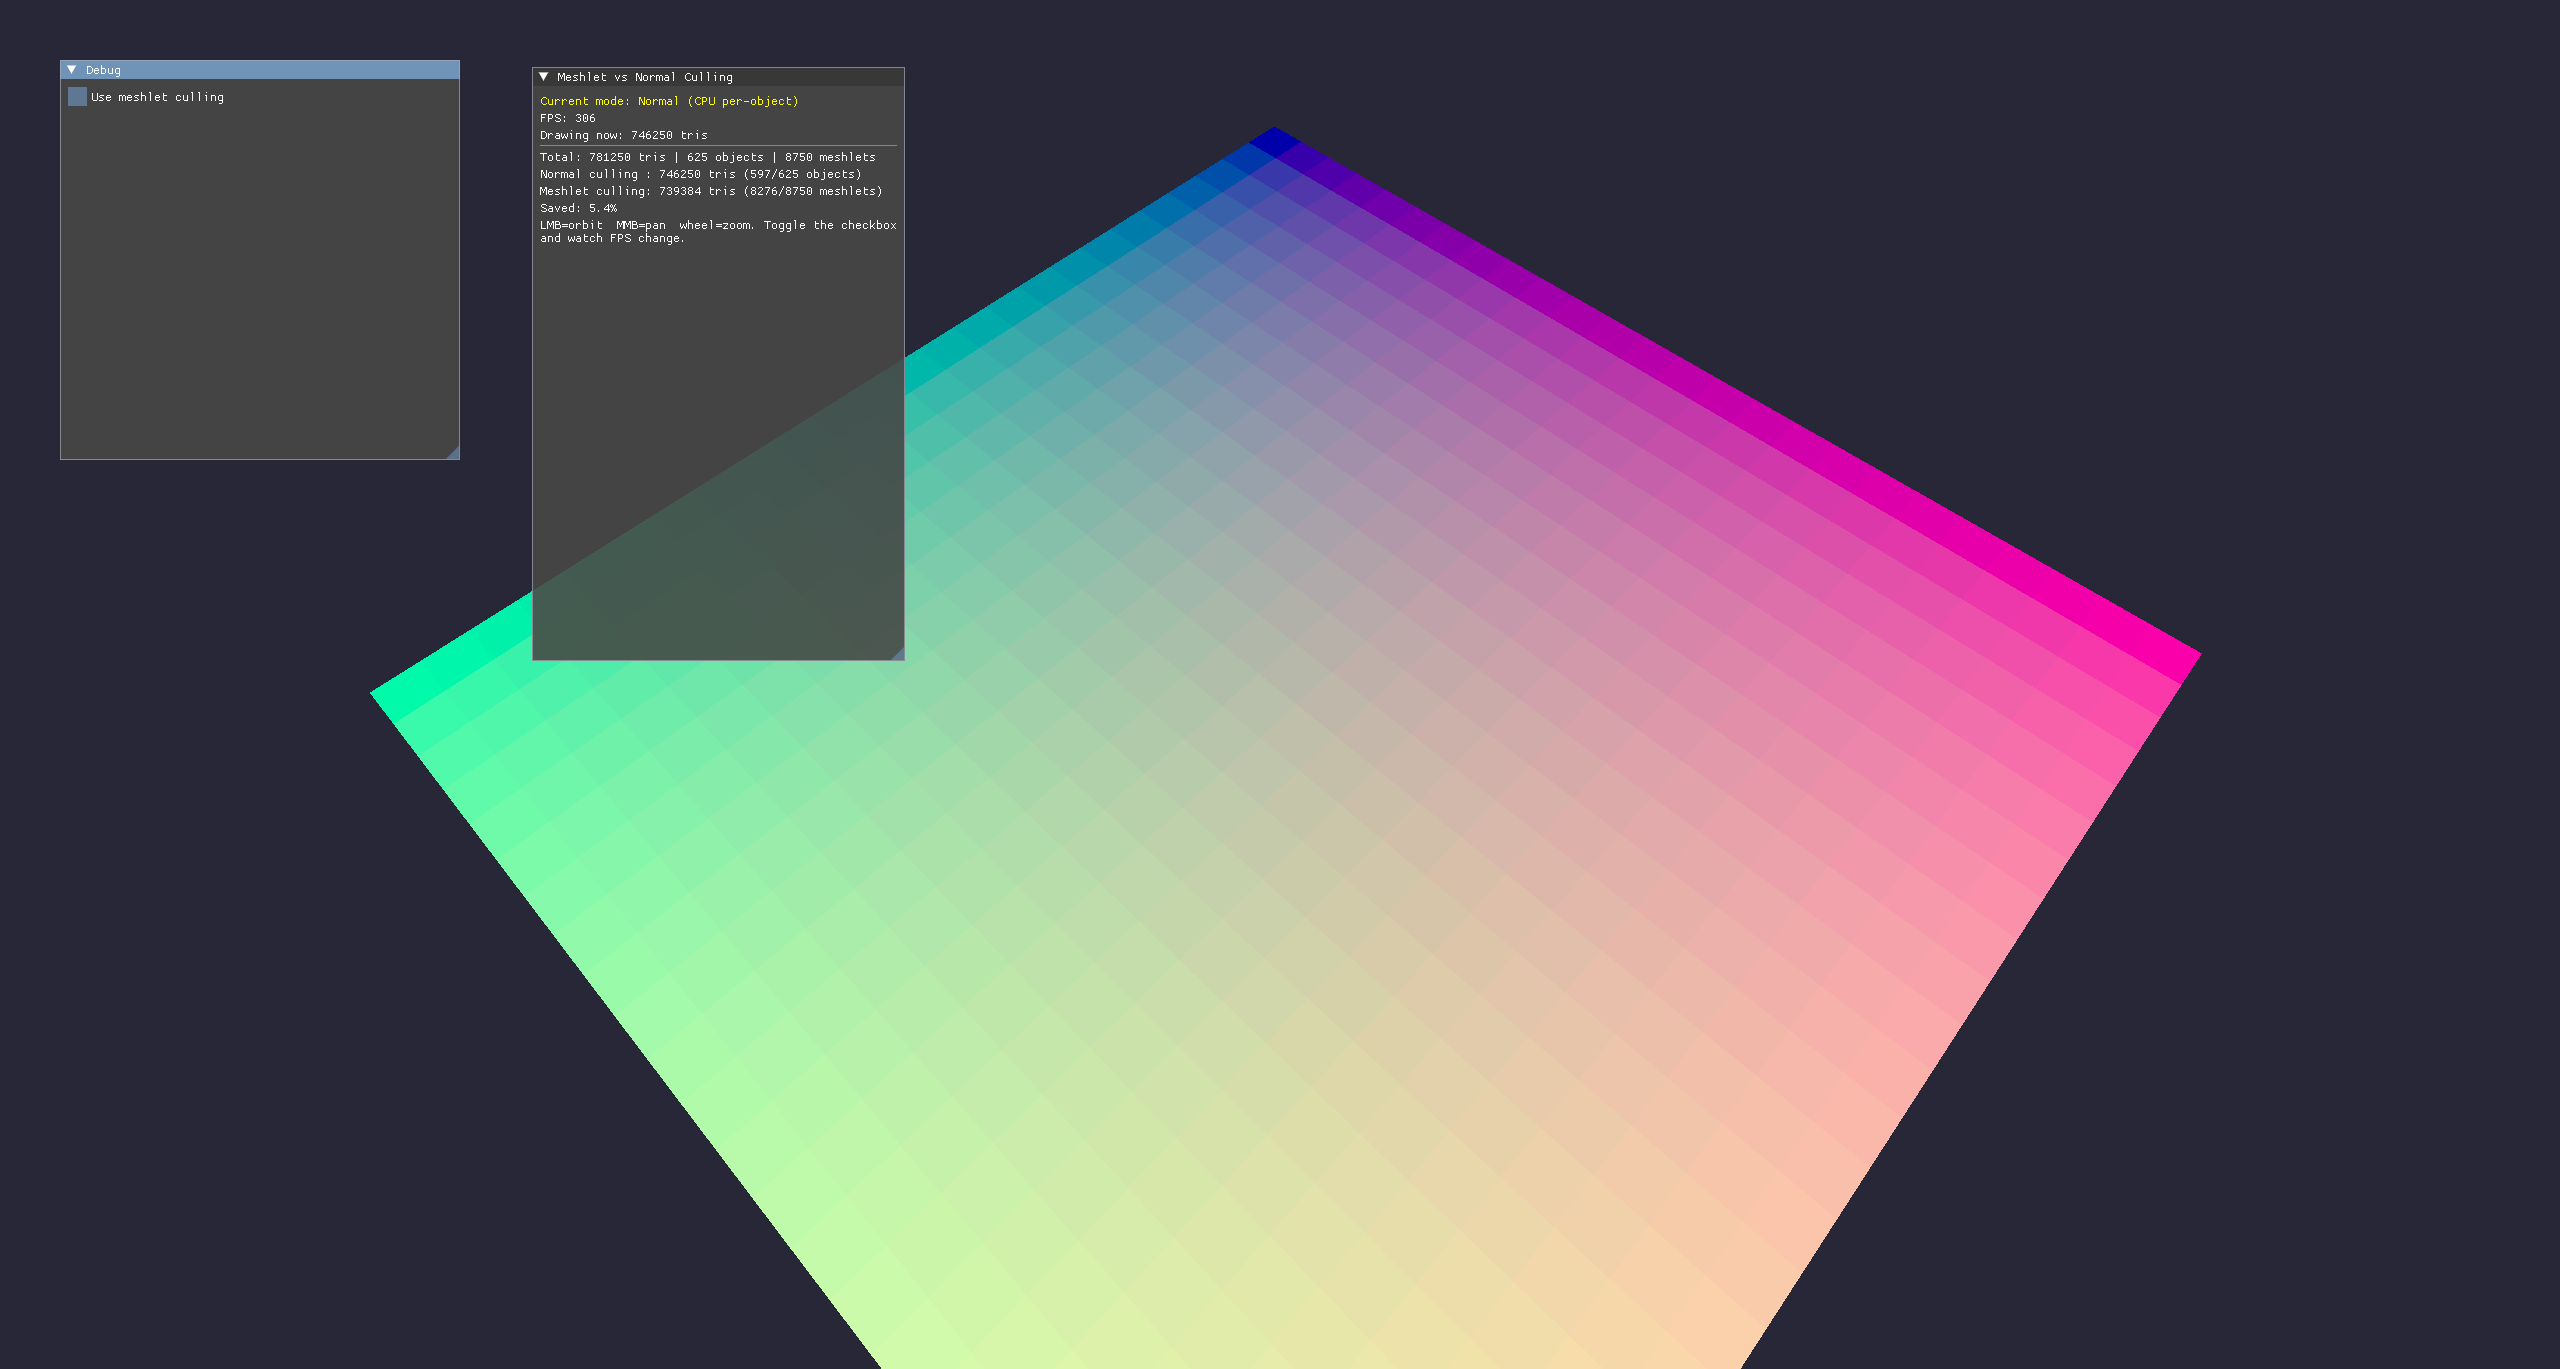
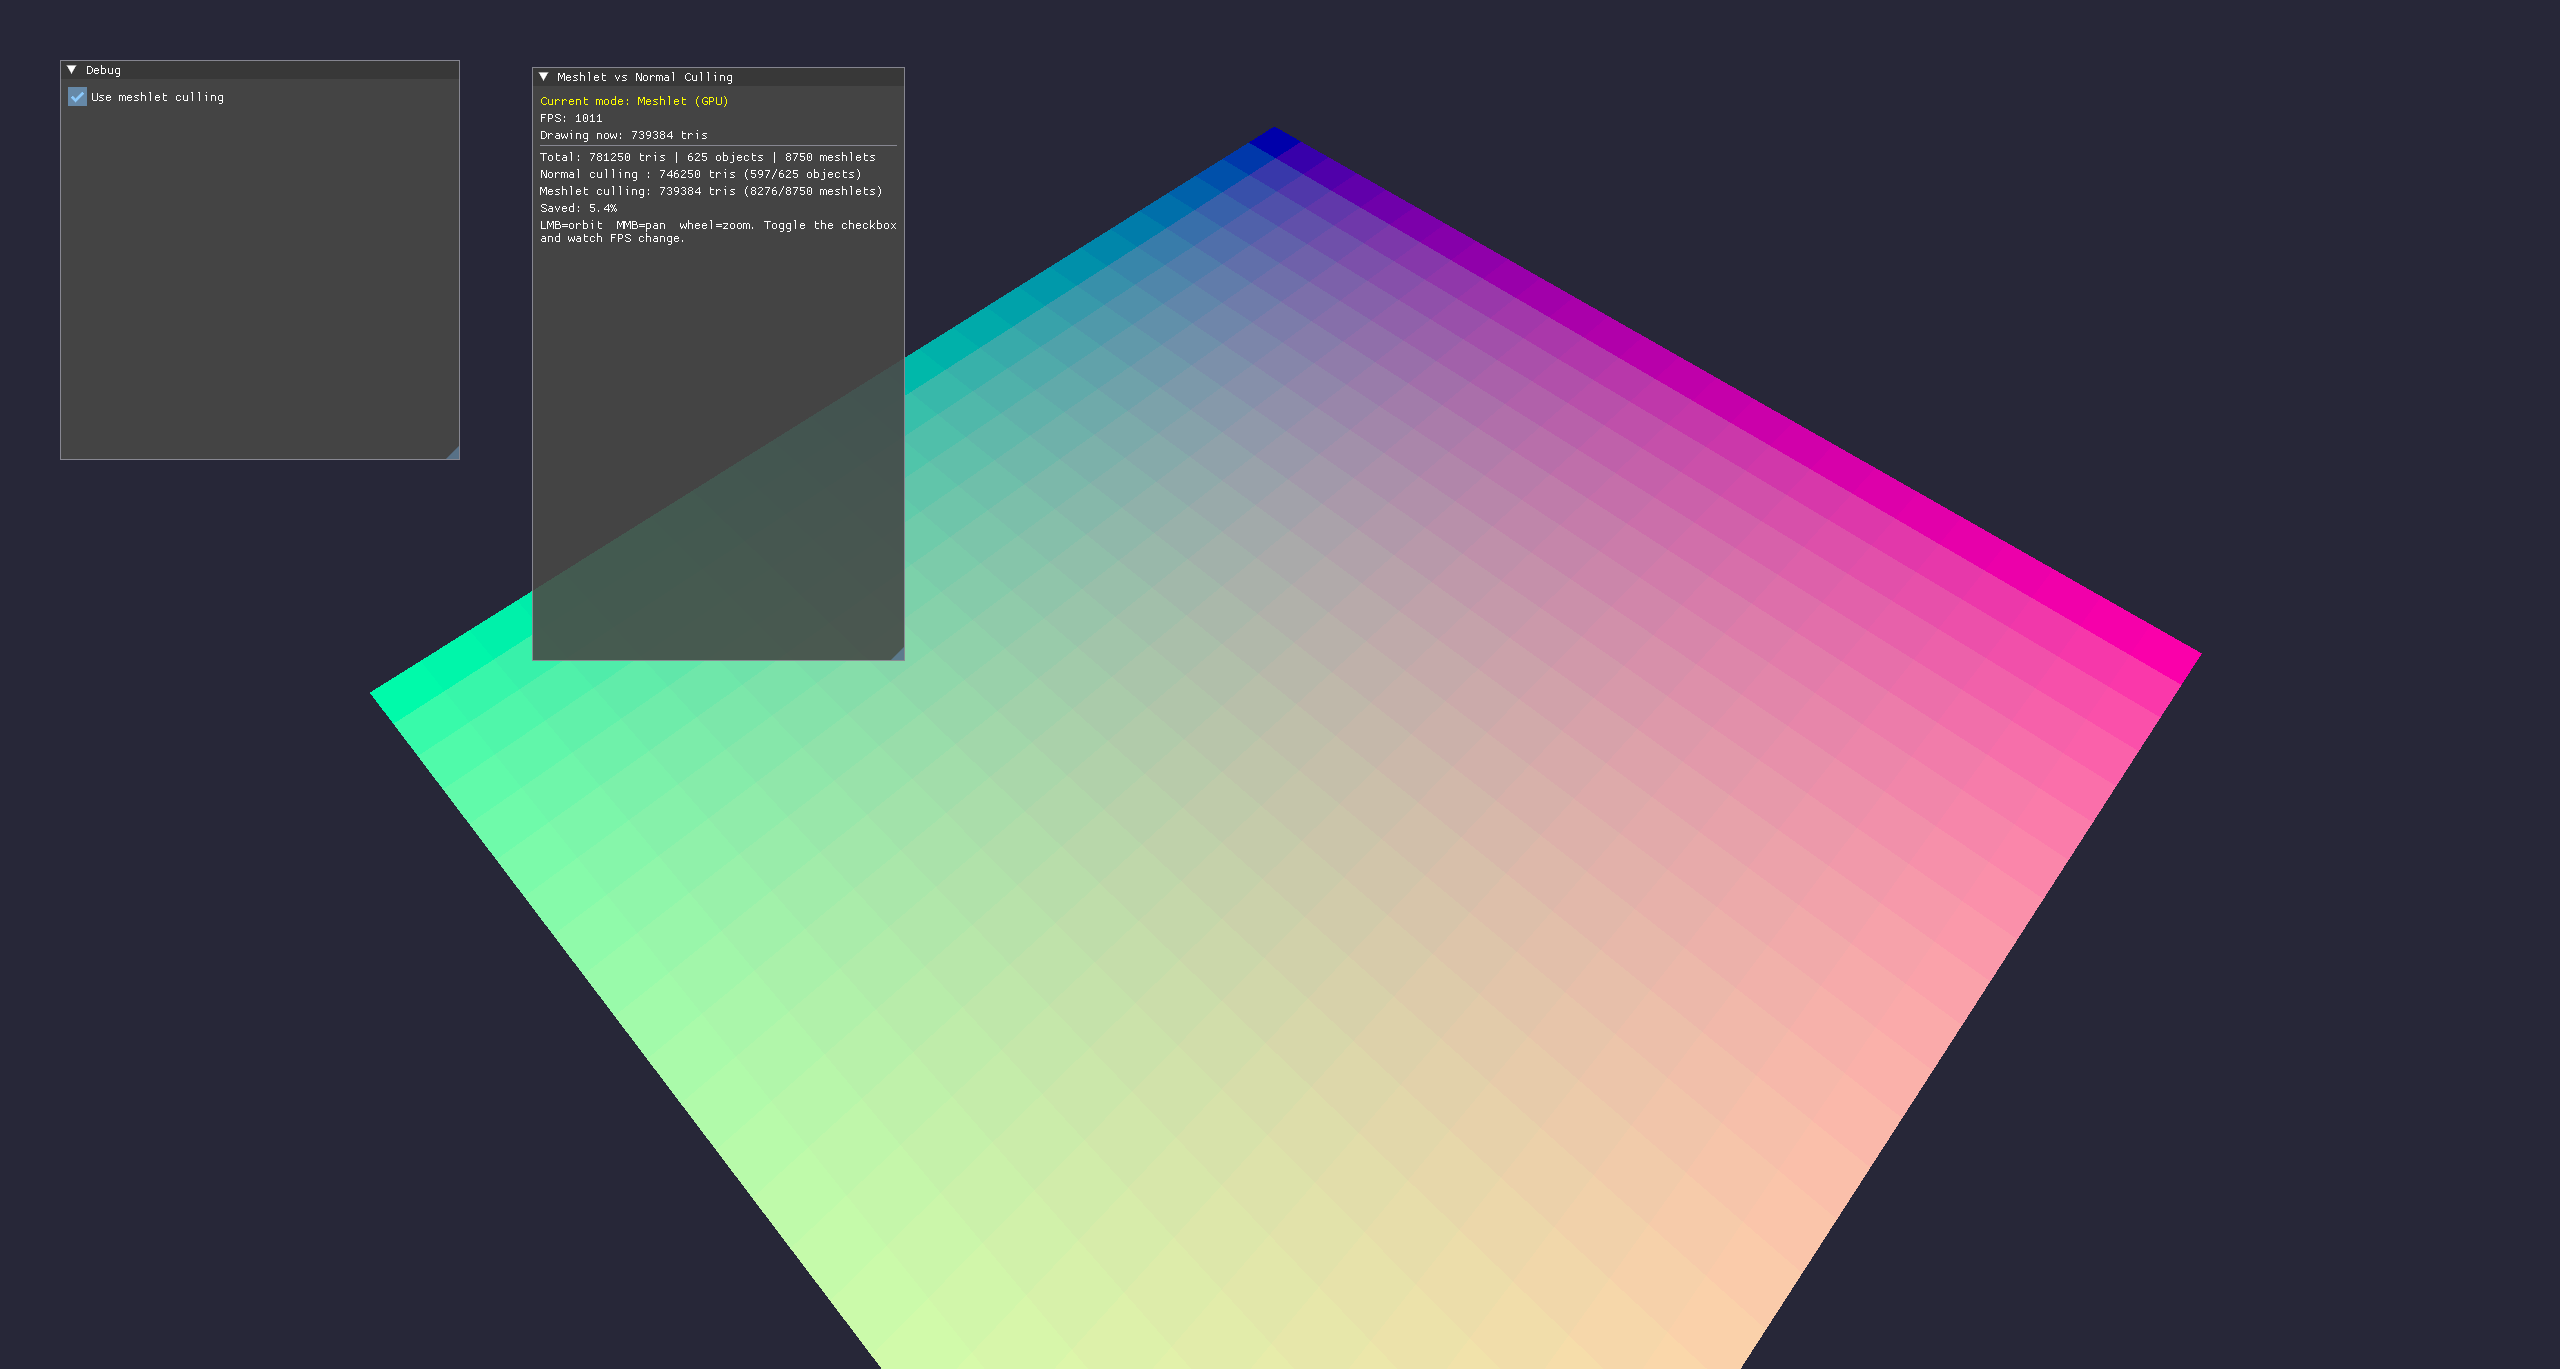
case 5可以直观看到meshlet的剔除效率。
打开meshlet前,帧率300FPS+:
打开meshlet后,帧率1000FPS+:
一、剔除的困境:太粗不行,太细也不行
在渲染里,“剔除”(culling)的意思是:把屏幕上根本看不见的东西提前丢掉,不浪费显卡算力。判断的标准通常有两条:视锥剔除(在相机视野外吗?)和背面剔除(朝向相机的背面吗?)。
关键问题来了:拿多大的一块去判断?
方案 A:整对象剔除(太粗)
传统做法是按”对象”来。比如这个场景里,地面被拆成了 625 个小方块(patch),每个方块 1250 个三角形。CPU 每一帧给每个方块算一个包围球,判断它是否在相机视野外。
问题在于:一个 patch 太大了。只要一个方块的包围球和视野沾了一点边,哪怕实际上只有 1 个三角形可见,整块 1250 个三角形都得画。相机贴近地面的时候,几乎每个方块都”沾边”,结果就是——根本剔不掉多少,78 万三角形照样全画。
方案 B:逐三角形剔除(太细)
那干脆逐个三角形判断?78 万个三角形,每帧在 CPU 上逐个算视野,CPU 会先累死。而且 GPU 也不喜欢这种”一个三角形一条指令”的零碎任务——它喜欢批量、连续地工作。
方案 C:Meshlet —— 找一个中间颗粒度
Meshlet(网格簇)就是把一大片三角形,切成一个个”小包裹”,每个包裹里装几十个三角形。 剔除时以”包裹”为单位:整个包裹在视野外就整个丢掉,在视野内就整个留下。
这样:
- 颗粒度足够细,能真正剔除掉大量看不见的三角形;
- 又足够粗,一个包裹几百个顶点、几十个三角形,交给 GPU 批量处理不浪费。
一句话概括:
Meshlet 是在”逐对象太粗”和”逐三角形太细”之间,找到的一个黄金颗粒度。
二、一个形象的比喻
把整个场景想象成一张巨大的城市地图,三角形就是地图上的每一栋小房子。
- 传统逐对象剔除:按”区”来扔地图,一个区 1000 栋房子。你站在一个区边上,哪怕只看到这个区 1 栋房子,也得把整个区 1000 栋房子都打印出来。浪费。
- Meshlet:把地图预先切成一块块”街区”,每块几十栋房子。你只需要打印视野内(或部分在视野内)的街区,视野外的街区整块丢掉。省一大半纸。
而”怎么切街区”——这就是 meshlet 生成算法要解决的问题。
三、Case05 里的 Meshlet 算法:贪心 BFS 区域增长
我用一个真实项目(MagicXEngine 的 Case05)来讲这个算法。它的输入是一整片 78 万三角形的地面,输出是约 8000 个 meshlet。
整体思路只有三句话:
- 先建邻接表:搞清楚”谁和谁挨着”。
- 贪心 BFS 切块:从一个三角形出发,沿着”共享边”把邻居一个个拉进来,直到装不下。
- 算剔除信息:给每块算一个包围球 + 一个法线锥,供 GPU 剔除用。
下面逐步拆开。
第 1 步:建邻接表(谁和谁共享一条边)
遍历所有三角形,把每条边登记到”这条边被哪些三角形共享”的映射表里:
1 | std::unordered_map<Edge, std::vector<uint32_t>> edgeTris; |
MakeEdge 有个小技巧:把两个顶点索引 swap 成”小的在前”再打包成一个 64 位整数,这样 (v0, v1) 和 (v1, v0) 会被识别成同一条边。
为什么按”边”找邻居,而不是按”顶点”? 因为一个顶点周围可能放射出几十个三角形,按顶点扩展会把簇拉成不紧凑的”扇形”。而按边扩展,两个三角形必须实实在在贴着一条边才算邻居,簇才会长成连成一片的紧凑块。
第 2 步:贪心 BFS 切块(核心)
扫所有三角形,遇到还没被分配的,就把它当种子,开一个新的 meshlet,用队列做 BFS 往外”长”:
1 | std::queue<uint32_t> q; |
两个上限(对应 mesh shader 的硬件惯例):
- maxVerts = 64:一个簇最多 64 个唯一顶点;
- maxTris = 126:一个簇最多 126 个三角形。
这里藏着一个 meshlet 的核心收益——顶点复用。相邻三角形共享顶点,所以 wouldFit 判断”加入这个三角形会引入几个新顶点”:
1 | auto wouldFit = [&](uint32_t t) { |
结果就是:一个 64 顶点的簇,能装下约 98 个三角形(而不是 64 个)。因为每加一个相邻三角形,往往只带来 1 个新顶点。
小彩蛋:
stamp是个很巧的 O(1) 去重技巧——每个簇分配一个唯一的”戳记号”,顶点被收进当前簇就盖上这个号。判断”顶点在不在簇里”只需比较戳记,不用每次线性扫描。开新簇时stamp++,旧戳记自动失效。
第 3 步:算剔除信息(包围球 + 法线锥)
一个簇切完,立即给它算两个”快速剔除代理”:
1 | // 包围球:中心 = 顶点均值,半径 = 最远顶点距离// 用途:视锥剔除 —— "这个球在视野外吗?" |
- 包围球(bounding sphere):GPU 判断这个簇在不在相机视野外,只需要做”球心到 6 个视锥平面的距离”测试,几个点积就搞定。
- 法线锥(normal cone):如果整簇三角形的朝向都背对相机,可以整簇跳过,这是背面剔除。
(本项目里法线锥目前算了但还没真正用上,是为后续背面剔除预留的。)
第 4 步:输出
每个簇生成一条描述记录(共 48 字节),并把它的三角形索引连续写入一个”重排索引缓冲”:
1 | Meshlet{i}: 索引缓冲 [firstIndex .. firstIndex + indexCount) |
注意:只重排索引,顶点不重排。所以顶点缓冲还是原来那一份,只是索引被打包成”一个簇一段”。
四、切完之后,GPU 怎么用这些 meshlet?
这才是 meshlet 的”爽点”所在——整个 78 万三角形的场景,剔除 + 绘制只花 GPU 上极少的几次调用:
1 | ① Compute 剔除(一次 dispatch) |
整个过程 CPU 全程不参与——不用遍历 625 个对象、不用算 8000 次包围球。这就是所谓 GPU-Driven 的精髓:把剔除这种”脏活”也交给 GPU 干,让 CPU 彻底解放出来。
对应的 compute shader 核心逻辑:
1 | // 视锥剔除:包围球 vs 6 平面 |